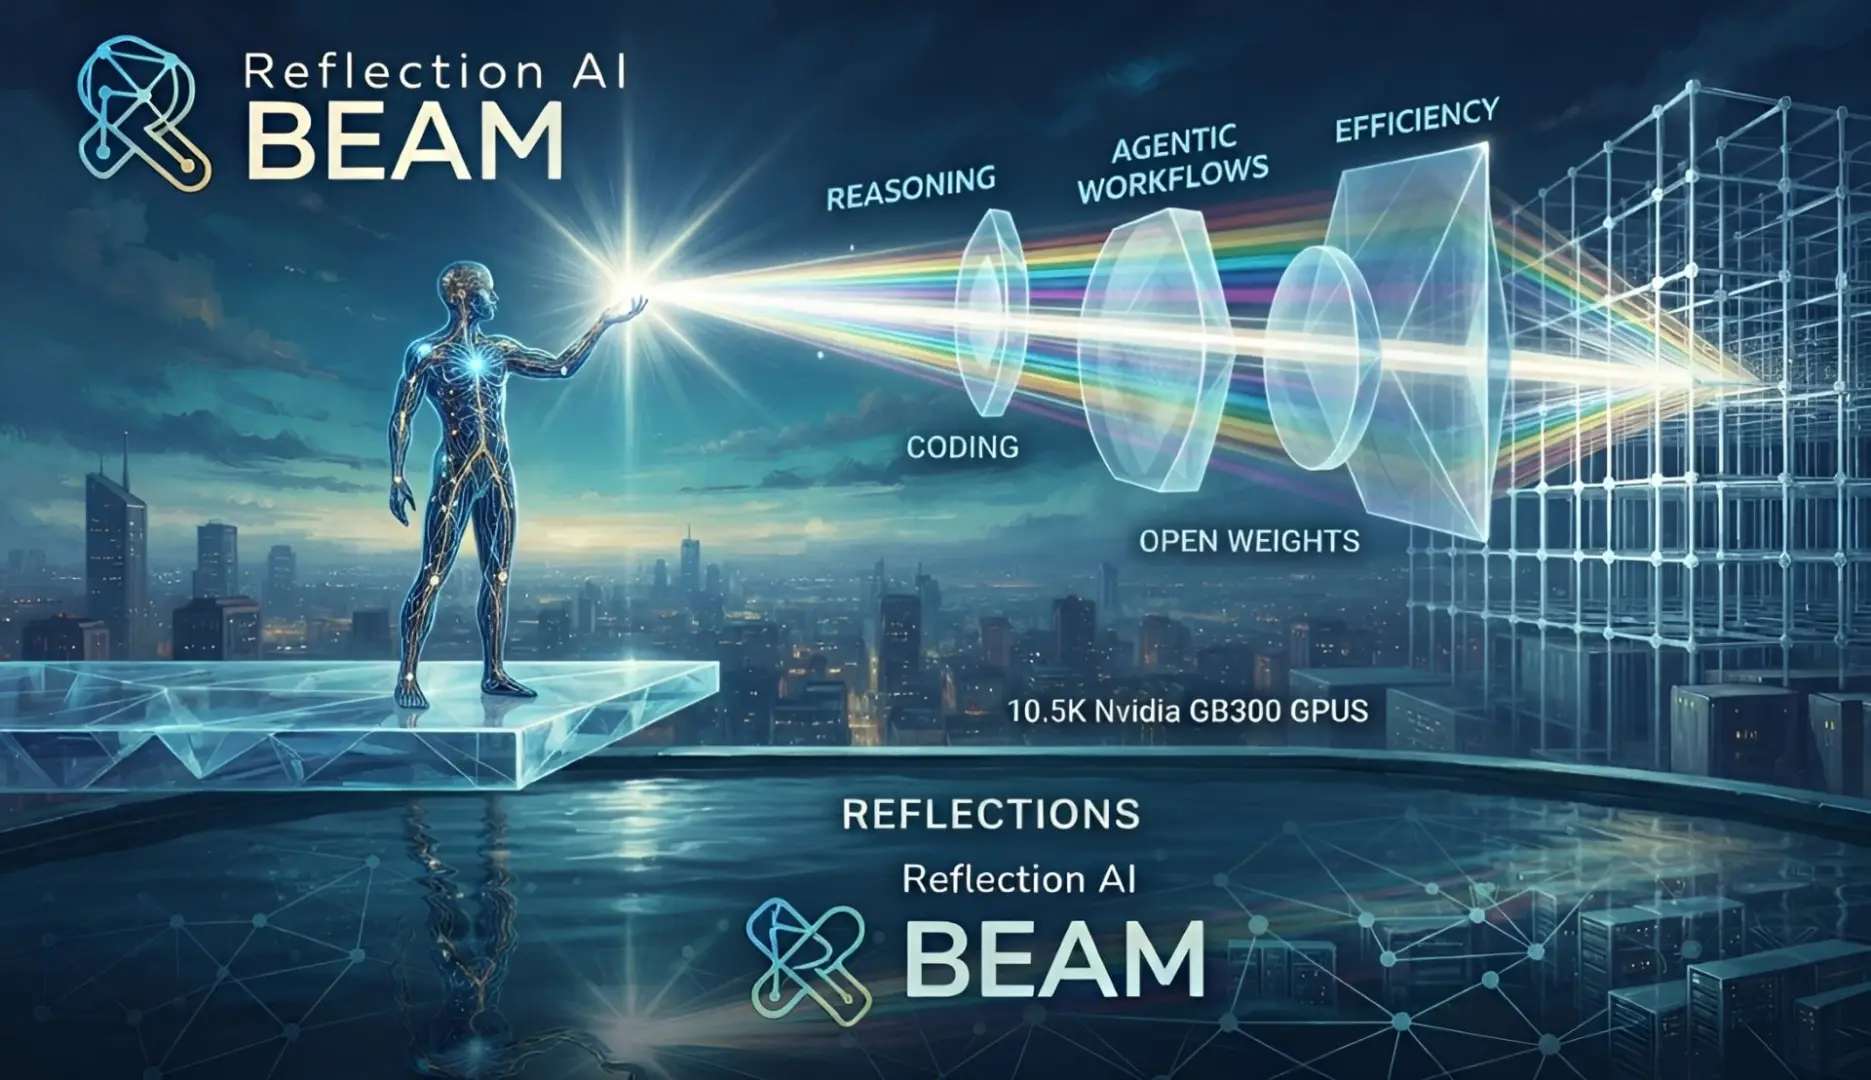
Yapay zeka alanında Batı'daki araştırma laboratuvarları, verimli açık kaynaklı modeller konusunda Çinli DeepSeek ve Zhipu gibi devlerle rekabet etmeye başlıyor. Bu rekabetin son örneklerinden biri, inanılmaz derecede verimli olduğu belirtilen 501 milyar parametreli, Mixture of Experts (MoE) mimarisine sahip Reflection'ın Beam modeli.
Reflection, Beam'in GLM 5.2'den 3-4 Kat, Batı'daki Önde Gelen Açık Kaynak Modellerden İse 4 Kat Daha Verimli Olduğunu İddia Ediyor
Reflection'ın Beam modeli, 501 milyar parametreye sahip olmasına rağmen, herhangi bir anda yalnızca 23 milyar parametresini aktif olarak kullanıyor. MoE mimarisini anlamak için büyük bir mutfak hayal edebilirsiniz; bu mutfakta uzmanlaşmış birçok aşçı (yönlendirilmiş uzmanlar) bulunur. Model, yalnızca ihtiyaç duyduğunda bu uzman aşçıları devreye sokar. Örneğin, bir sufle hazırlamak için model yalnızca tatlı uzmanlarını devreye sokar, Doğu mutfağı konusunda uzman olanları değil.
Bir yapay zeka modeli temelde birbirine bağlı iki ana bileşenden oluşan bir dizi transformatör bloğundan oluşur:
- Dikkat Katmanı (Attention Layer): Cümledeki kelimelerin birbirleriyle nasıl ilişkilendiğine bakar. Örneğin, modele "Paris, Fransa'nın başkentidir" gibi bir komut verildiğinde, dikkat katmanı 'başkent' kelimesini 'Fransa' ile ilişkilendirir ve cevabı 'Paris' olarak belirler. Ancak bu katman, Fransa veya Paris'in ne anlama geldiğini bilmez, sadece bu bilgiyi KV önbelleğinde saklar. Bağlam arttıkça KV önbelleği de büyür.
- İleri Beslemeli Ağ (Feed-Forward Network - FFN): Modelin tüm bilgisini ağırlıklar şeklinde depolar. Bu katman, her kelimenin arkasındaki anlamı derin matematiksel formüller kullanarak ortaya çıkarır. Örneğin, Fransa kelimesine bakıp ülkeye ait ansiklopedik bilgileri devreye sokar.
KV önbelleğinin büyümesini engelleyerek verimliliği artırmak için Beam, şu yöntemleri kullanır:
- Tekdüze Uzman Kullanımı: Tüm uzman aşçılar kabaca eşit miktarda iş alır. Bu, hiçbir uzmanın aşırı yorulmasını veya uzun süre boşta kalmasını önler. Reflection'a göre, Beam'in en yoğun uzmanı bile ortalamadan yalnızca 1.04 kat daha yoğundu, bu da neredeyse mükemmel bir denge anlamına gelir.
- Derinliğe Dayalı Kalıntı Ölçeklendirme ve Kontrollü Kalıntı Akışı: Modeller tipik olarak belirteçleri (token) onlarca ardışık katmandan geçirir; burada bireysel alt katmanlardan (dikkat ve ileri beslemeli ağlar gibi) gelen matematiksel çıktılar sürekli olarak birikir. Ancak modeller büyüdükçe, bu kümülatif toplama genellikle büyük aktivasyon büyümesine ve sayısal sapmalara yol açarak sinyal bozulmasına veya eğitim dengesizliğine neden olur. Bunu önlemek için Beam, belirteç ağın derinliklerine ilerledikçe her alt katmanın çıktılarının büyüklüğünü kademeli olarak azaltan ölçeklendirme faktörleri kullanır ve bilginin temiz, öngörülebilir bir şekilde akmasını sağlar.
- SandwichNorm: Modeller tipik olarak belirteçleri bir alt katmana girmeden önce veya çıktıktan sonra normalleştirir. Bu, belirteç değerlerinin katı, öngörülebilir bir aralıkta kalmasını sağlar. Beam ise, belirteçleri her alt katman girişinde ve çıkış noktalarında (sandviçleme) normalleştirerek aktivasyonların (belirteçler birden çok transformatör katmanı tarafından işlenirken modelin ürettiği dahili matematiksel temsiller, gizli durum olarak da adlandırılır) asla sapmamasını veya aşırı sayısal sapmalar oluşturmamasını sağlar.
- Dikkat Kapılama (Attention Gating): Model dikkat hesaplamasını yaptıktan (KV önbelleği oluşturduktan) sonra, bu dikkatin ne kadarının gerçekten kullanılacağını belirleyen küçük bir "ses düğmesi" (bir kapı) bulunur. Farklı kısımlar için sinyali açıp kapatabilir, bu da modeli daha seçici ve kararlı hale getirir.
- FP32 Kalıntı Birikimi: Model hız ve bellek tasarrufu için daha ucuz, düşük hassasiyetli sayılarla çalışırken, önemli kalıntı (atlama bağlantısı) toplamaları hala tam yüksek hassasiyetli 32-bit sayılarla yapılır. Bu, küçük yuvarlama hatalarının birikerek eğitimi bozmasını engeller.
Reflection'ın Beam modelini bu kadar verimli kılan unsurları inceledikten sonra, eğitim sürecine göz atalım. Bir model ön eğitimden geçtikten sonra, yapay zeka laboratuvarları genellikle Pekiştirmeli Öğrenme (RL) adı verilen bir işlem gerçekleştirir. Bu süreçte model, kodlama gibi pratik beceriler öğretmek için kendi sanal alanlarındaki (sandbox) çok sayıda ajan ile bağlanır.
Reflection, özel blog yazısında şunları belirtti:
Reflection, Beam'i 4 hafta (28 gün) boyunca eğittiğini ve 10.500 NVIDIA GB300 GPU üzerinde konuşlandırılmış 1,3 milyar sanal alan kullandığını belirtti. Bu, günde 46,4 milyon sanal alana denk geliyor. Pekiştirmeli öğrenme, 1 milyon kodlama, ajan tabanlı ve STEM ortamlarını kapsadı ve 100 milyon döngüyü (bir ajanın belirli bir ortamla etkileşiminden elde edilen sonuç ve ilgili ödüller) içerdi.
DeepSeek'in özel DSec biriminin 3 milyon sanal alan işlediğini belirtmek gerekir. Reflection'ın ölçeğine ulaşmak için DeepSeek'in yaklaşık 16 DSec birimi çalıştırması ve birim başına yaklaşık 656 GB300 (toplamda ~10.500 GPU) kullanması gerekirdi.
Genellikle Pekiştirmeli Öğrenme'de, önceki oturumlardan öğrenilen sonuçlarla model ağırlıkları güncellenirken eğitimin durması gerekir. Ancak Reflection, iş akışını ayırdı:
- Döngü İşçileri (Rollout Workers): Sürekli olarak belirteç yanıtları üretirler.
- Öğrenici Motorlar (Learner Engines): Bu yanıtları kullanarak model ağırlıklarını sürekli günceller.
Öğrenici motorlar, döngü işçileri metin üretmeye devam ederken modeli güncellediği için, veriler senkronizasyon dışı kalır (asenkron politika gradyanları) ve politika esnekliği olarak bilinen bir duruma yol açar. Beam, bu durumun neden olduğu gürültü ve sayısal uyumsuzluğu, temel stabilizasyon grubu aracılığıyla giderir: SandwichNorm, dikkat kapılama ve derinliğe dayalı kalıntı ölçeklendirme (hepsi daha önce açıklanmıştır). Tüm bu akıllı yöntemleri kullanarak Reflection, Beam'in eğitimini önemli ölçüde hızlandırmayı başardı.
Sonuç olarak, Beam'in performansı büyük ölçüde GLM-5.2'ninkiyle eşleşirken, çıkarımla ilgili hesaplama maliyeti yaklaşık 3-4 kat daha az oluyor. Elbette Beam hala Qwen 3.8 Max'ın gerisinde kalıyor ancak model yine de boyutuna göre son derece güçlü.