Teknoloji devi Qualcomm, yapay zeka çıkarım süreçlerindeki bellek bant genişliği darboğazını çözmeyi hedefleyen Yüksek Bant Genişlikli Hesaplama (HBC) silikonunun ilk neslini San Diego'daki laboratuvarında başarıyla test ettiğini duyurdu. Bu çip, yapay zeka çıkarımı için geliştirilen yeni nesil bellek tasarımına dair erken donanım kanıtları sunuyor. Testler sırasında çip, üretim ortamına yakın koşullarda, endüstri standardı test ekipmanları kullanılarak tam bellek okuma-yazma yolunu ve bellek içi hesaplamaları gerçekleştirdi.
Chip Üreticisinin Dragonfly AI250 Modeli 2027'nin İlk Yarısında Örnek Üretimle Geliyor
Qualcomm, büyük dil modellerinin (LLM) çıkarımında karşılaşılan temel kısıtlamanın bellek bant genişliği olduğunu belirtiyor. Zira her yeni belirtecin (token) üretilmesi için model verilerinin işlem birimlerine taşınması gerekiyor. Veri merkezi ölçeğinde bu veri hareketinin enerji tüketimi ve gecikme süresi, işlem verimliliğini, güç tüketimini ve toplam sahip olma maliyetini doğrudan etkiliyor. HBC teknolojisi, işlem birimlerini belleğe daha yakın konumlandırarak veri hareketini azaltmayı ve etkin bant genişliğini artırmayı amaçlıyor.
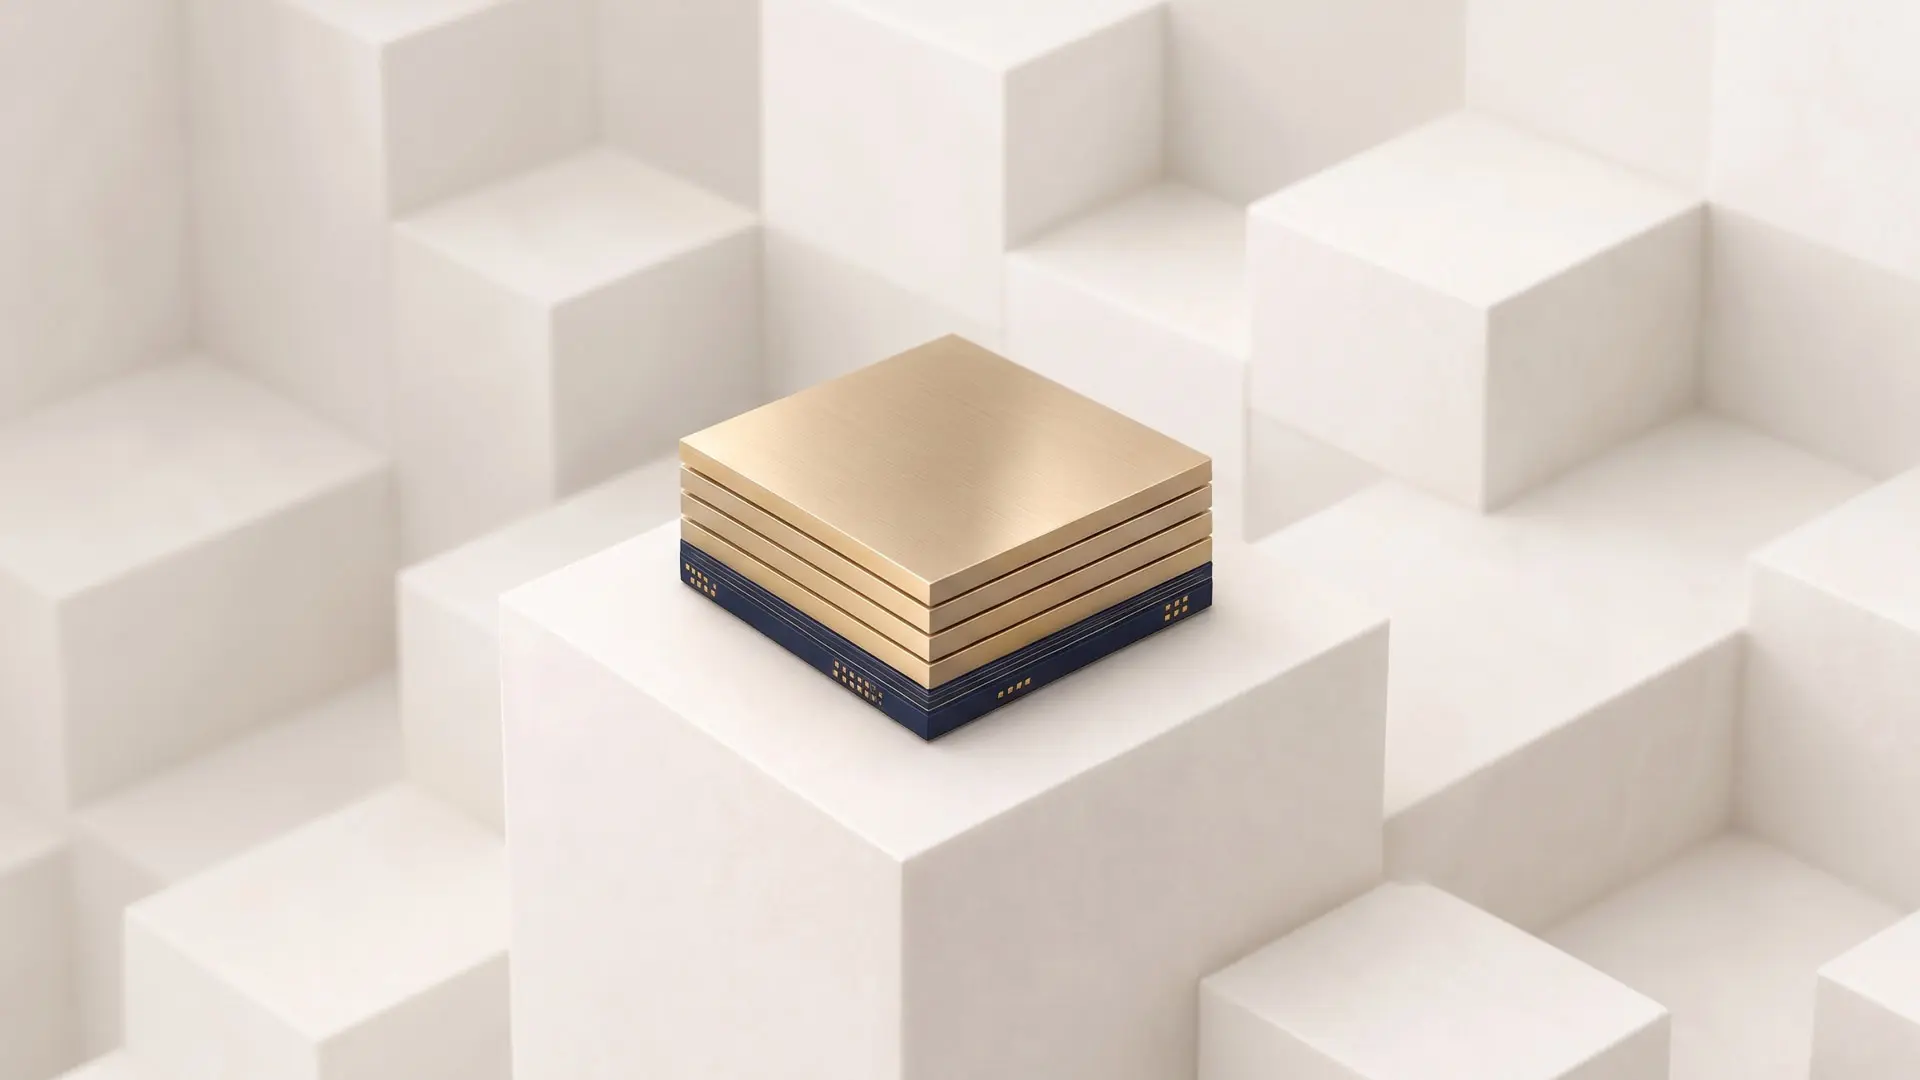
Qualcomm'un HBC tasarımı, wafer-to-wafer birleştirme teknolojisiyle düşük güçte LPDDR yongalarını aktif bir yapay zeka hızlandırıcı temel yongasının üzerine istifliyor. Bu sayede verinin kat etmesi gereken mesafe milimetrelerden mikrometrelere kadar kısalıyor. Elde edilen sonuçlara göre bu yaklaşım, LPDDR5X'e kıyasla etkin bellek bant genişliğini 18 kat artırıyor ve öngörülen HBM4 spesifikasyonlarının watt başına bant genişliğinin 5 katından fazlasını sunuyor.
Ancak, verimlilik artışları, Qualcomm'un daha önce öngördüğü 6 katlık performansın biraz altında kaldı. Qualcomm'un notlarına göre bu rakamlar, ölçülen silikon sonuçlarının hedeflenen çalışma koşullarına normalize edilerek elde edilen tahminlere dayanıyor ve rakip ürünlerin yayınlanmış spesifikasyonlarıyla karşılaştırılıyor. Nihai performansın uygulamaya, iş yüküne ve sistem yapılandırmasına göre değişiklik gösterebileceği belirtiliyor.
Qualcomm ayrıca, mimari geliştirme, süreç geliştirme, test araçları, silikon doğrulama ve ürün entegrasyonunu kapsayan aşamalı bir programdan bahsediyor. Ayrıca wafer-to-wafer birleştirme işlemini standart hale getirmek için dökümhane ve montaj ortaklarıyla çalıştıklarını da ekliyor. İstiflenmiş katmanlardaki kusurları gidermek için tasarımda yedeklilik ve yeniden eşleme mekanizmaları bulunuyor, bu da hatalı bellek alanlarının etrafından dolaşılmasını sağlıyor. Chip üreticisi ayrıca, belleğin mantık üzerine yerleştirilmesi konusunda on yılı aşkın bir deneyime sahip olduğunu ve ticari olarak DRAM'in mantık üzerine doğrudan birleştirilmesinin yanı sıra JEDEC LPDDR standartlarının oluşturulmasına da katkı sağladığını vurguluyor.
Qualcomm'un ticari ürünlerinde, mevcut iki katmanlı yapının yerine dört katmanlı bir DRAM istifinin kullanılması bekleniyor. Ürünlerden bahsedecek olursak, Dragonfly AI250 modelinin 2027'nin ilk yarısında örneklenmesi hedefleniyor ve bu model Qualcomm'un Dragonfly Rack çıkarım altyapısına entegre edilecek. Donanım özellikleri arasında 38.6 TB bellek ve saniyede 7.4 petabaytlık etkin bant genişliği sunan tam sıvı soğutmalı bir raf bulunuyor.
Qualcomm'un iç lansman stratejisi, 2027'de Oryon tabanlı C1000 sunucu CPU'sunu ve ardından 2028'de Dragonfly AI300'de yeni nesil HBC'yi devreye almayı planlayarak sunucu tarafına doğru ilerleyecek. Bu gelişmeler kuşkusuz önemli bir iyileşme sunsa da, bu sonuçların Qualcomm'un kendi laboratuvarından ve erken silikon aşamasından elde edildiğini unutmamak gerekiyor. Bağımsız kıyaslamaların farklı bir tablo çizebilme ihtimali bulunuyor ve bu konuda ilerleyen zamanlarda okuyucularımızı bilgilendireceğiz.
Kaynakça: wccftech.com