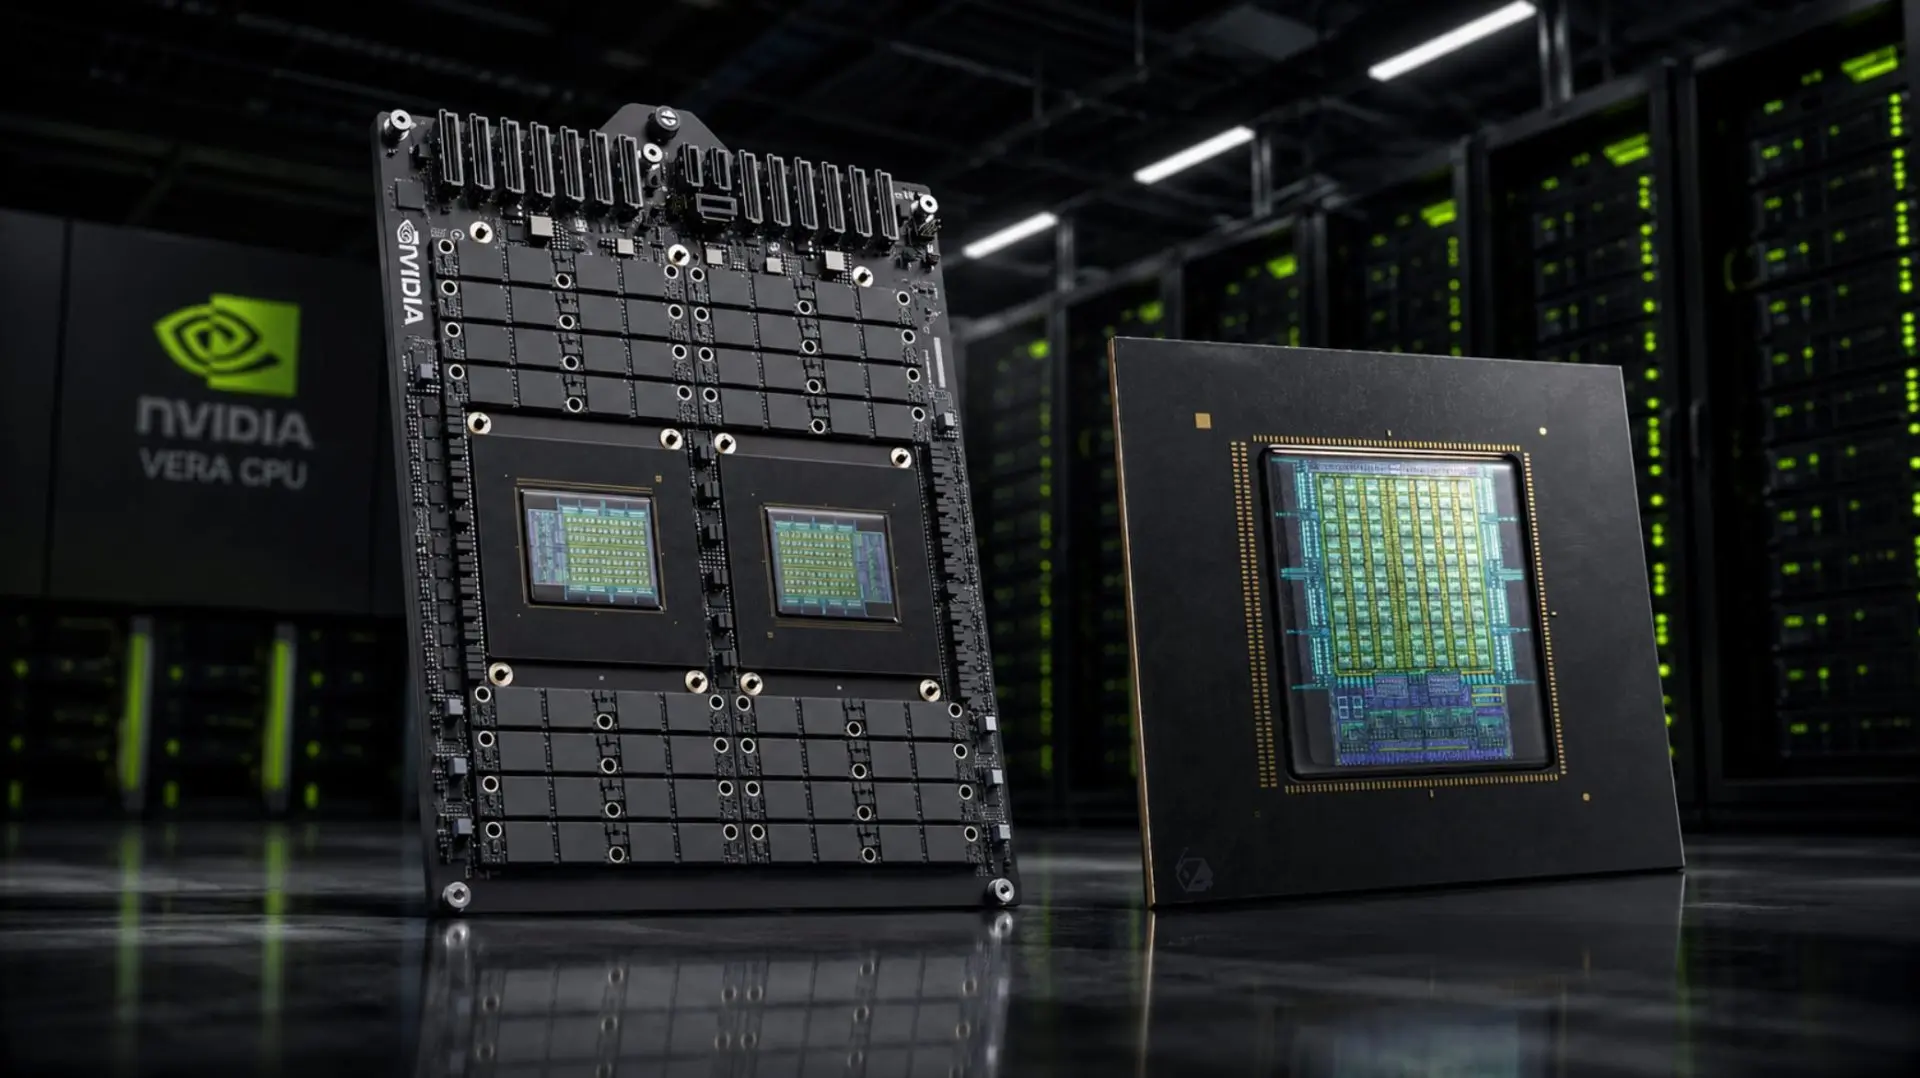
Teknoloji dünyasında yapay zeka alanındaki gelişmeler hız kesmeden devam ederken, işlemci mimarilerinde de köklü değişimler yaşanıyor. Geleneksel, görevleri izole eden yaklaşımdan, organize edilmiş ve ajans tabanlı bir zeka ekosistemine geçiş yapan NVIDIA'nın Vera CPU'su, merkezi işlem biriminin (CPU) rolünü genel amaçlı çoklu görevlerden, yapay zeka ajanlarının karmaşık, çok adımlı akıl yürütme döngülerini yönetmeye odaklanan özel bir yöneticiliğe taşıyor.
Yapay zeka ajanlarının hızla büyüyen ekonomisinde CPU'nun gelişen rolü hakkında önemli bilgiler edindik. Bu bağlamda, tek çekirdek performansının yeniden doğuşunu, CPU tarafından kontrol edilen yapay zeka ortamlarının devasa ölçeğini ve CPU-GPU oranındaki evrimi ele aldık.
Yıllarca Çekirdek Sayısını Önceliklendiren Bulut Altyapısı, Yapay Zeka ile Tersine Dönüyor: NVIDIA Vera Bir Paradigma Değişiminin Göstergesi
Soru: Vera CPU tam olarak nedir, kısaca özetler misiniz?
Yanıt: 2010'ların başlarında veri merkezi tasarımları, çekirdek sayısından ziyade tekil işlemci çekirdeklerinin performansını en üst düzeye çıkarmaya odaklanıyordu. Bu dönemde Intel gibi pazar liderleri, daha yüksek saat hızlarında çalışan daha az çekirdeğe sahip mimarilere (Haswell nesli gibi) odaklanmıştı. Bu dönem, yüksek tek çekirdek performansı ancak düşük genel verimlilik ile karakterize edilen CPU tasarımının sol üst çeyreğinde yer alıyordu.
Devasa bulut hyperscaler'ları büyüdükçe, sektör ölçek ekonomilerine doğru kaydı. Sunucu başına geliri en üst düzeye çıkarmak için tek bir sunucuya mümkün olduğunca çok çekirdek yerleştirme talebi arttı. Bu yoğunluğu elde etmek ve maliyetleri kontrol etmek için x86 satıcıları tek çipli tasarımlardan çok çipli düzenlere geçiş yaptı. Ancak çekirdek sayısındaki bu büyük artış, tek çekirdek optimizasyonunun ve Döngü Başına Talimatlar (IPC) değerlerinin doğrudan aleyhine oldu. Bu dönem, büyük verimlilik ancak düşük tek çekirdek performansı sunarak sağ alt çeyrekte yer alıyordu.
Ajans tabanlı yapay zekanın yükselişi, CPU'yu donanım tasarım yolunun merkezine geri yerleştirdi. Yapay zeka ajanları, GPU ve CPU arasında sürekli ve hızlı bir döngüde çalışır. GPU'lar bir yapay zeka fabrikasındaki en pahalı ve değerli varlıklar olduğu için, CPU'nun GPU'yu boşta bekletmemesi adına sıralı görevlerini anında tamamlaması gerekir. Bu paradigma, hız, bellek erişimi ve minimum gecikme konusunda eşi görülmemiş bir kombinasyon gerektirir.
NVIDIA'nın Vera CPU'su, bulut çağının tarihsel ödünleşimlerini kırarak, yüksek tek çekirdek performansı ile yüksek verimliliği bir araya getiren seçkin üst-sağ çeyreğe konumlanarak ajans darboğazını çözüyor. Bunu üç özel tasarım seçeneğiyle başarıyor: yüksek çekirdek başına hız, devasa bant genişliği için özel LPDDR5X bellek alt sistemi ve gecikmeyi ortadan kaldıran ikinci nesil NVIDIA Scalable Coherent Fabric ile güçlendirilmiş tek bir monolitik hesaplama çipi.
Özetle: Vera, NVIDIA'nın modern yapay zeka çağının belirli darboğazlarını gidermek üzere tasarlanmış, ajans yapay zekası için özel olarak üretilmiş ilk CPU'sudur. Bulut çağı, yoğun, düşük performanslı çipli çekirdeklerle verimliliği önceliklendirirken, ajans yapay zekası GPU ve CPU arasında hızlı bir döngü gerektirir. Pahalı GPU'ları yüksek oranda kullanmak için ajanlar yüksek tek çekirdek performansı, yüksek bellek bant genişliği ve düşük gecikme talep eder. Vera, bunları monolitik bir hesaplama çipi, özel bir LPDDR5X bellek alt sistemi ve ikinci nesil Scalable Coherent Fabric aracılığıyla elde ederek, yüksek tek çekirdek performansını yüksek verimlilikle birleştiren yeni bir kategoride yer alıyor.
CPU Fonksiyonunda Ayrışma, Olympus Çekirdekleri ve Uzamsal Çoklu İş Parçacığından Kaynaklanan Performans Vergisi
Soru: SK Hynix'in, SSD'lerin içindeki yaklaşık 100 küçük işlemcinin tekrarlanan düşük seviyeli görevleri yerine getirerek genel işlemcinin üst düzey görevlere odaklanmasını sağlayan HTPU'yu (Hynix Transaction Processing) duyurduğunu düşünürsek, NVIDIA da CPU fonksiyonlarında benzer bir ayrışmayı düşünüyor mu veya bu yönde adımlar atıyor mu?
Yanıt: Yapay zeka altyapısı ortamı, tek tip, hepsi bir arada sunucu düğümlerinden, yüksek oranda özelleşmiş, heterojen kurulumlara doğru kayıyor. Bu eğilimin en belirgin örneği, modern yapay zeka çıkarım iş yüklerinde görülüyor; verinin ilk okunması (ön doldurma) ve belirteçlerin sıralı üretilmesi (kod çözme) gibi farklı işlem aşamaları, verimliliği optimize etmek için artık tamamen ayrı donanım kümeleri arasında rutin olarak bölünmektedir.
NVIDIA'nın orijinal CPU stratejisi (Grace işlemcisi ile görüldüğü gibi), bir sunucu rafındaki bir GPU kümesine veri beslemek üzere tasarlanmış nihai "ana düğüm" işlemcisini oluşturmaya odaklanmıştı. Ancak, ajans iş akışlarının ve pekiştirmeli öğrenmenin benzersiz talepleri, özellikle NVIDIA'nın ajan araç çağrılarını ve pekiştirmeli öğrenme görevlerini yerine getirmek için saf CPU raflarının bir kullanım alanı olduğunu fark etmesiyle bir geri dönüşe zorladı.
Bu geri dönüş nedeniyle, Vera CPU artık sıkı bir şekilde entegre bir bileşen olarak, birleşik GPU-CPU mimarisi (Vera-Rubin yığını gibi) içinde hapsedilmiş olarak görülmüyor. Bunun yerine, Vera, ajan araç çağrıları ve akıl yürütme döngülerinin devasa hacimlerini işlemek üzere tasarlanmış "saf raflar" ile bağımsız, bağımsız bir CPU varlığı olarak ticarileştiriliyor.
Özetle: Belirli SK Hynix kullanım durumuna yorum yapamasak da, yapay zeka altyapısındaki genel eğilim büyük ölçüde ayrışmaya doğru ilerliyor. Vera'nın kendisiyle yapılan geri dönüş, bu yönde bir adımdır, çünkü NVIDIA, CPU'ları yalnızca birleşik bir yığın içindeki ana düğümler olarak kullanmak yerine, ajan araç çağrıları ve pekiştirmeli öğrenme için devasa bağımsız CPU raflarına ihtiyaç duyulduğunu fark etti.
Soru: NVIDIA, Grace'ten yaklaşık %50 daha yüksek IPC'ye sahip olduğunu belirtiyor, değil mi? Ve CPU'nun devasa bir 10 çekirdek genişliği var. Peki ya yanlış bir tahmin olursa, gecikme nasıl oluyor? Vera'nın Grace'e kıyasla toparlanması kaç döngü sürüyor? Bu konuda çok kaba bir taslak verebilir misiniz?
Yanıt: Vera CPU, öncülü Grace'ten 1,5 kat daha hızlı performans sunarak işlem gücünde devasa bir sıçrama sağlıyor. Özellikle Python betikleme ve kod derleme gibi sıralı görevlere dayanan ajans iş yüklerinde endüstrinin önde gelen x86 işlemcilerine karşı ölçüldüğünde, Vera 2 kata kadar daha hızlı ölçekleniyor ve geometrik ortalama bazında 1,6 kat avantaj sağlıyor.
Geleneksel Eşzamanlı Çoklu İş Parçacığı yöntemlerine güvenmek yerine, NVIDIA Uzamsal Çoklu İş Parçacığı olarak bilinen bir CPU yerel yeteneği uyguluyor. Bu özel özellik, çipin "işçi" ve "G/Ç" iş parçacıklarını katı bir şekilde tahsis etmesine olanak tanır. Bu bölümleme, veri merkezi genelindeki yoğun hesaplama yükleri altında bile, bir çekirdeğin arka plan işlemlerini yönetmek için birincil işleme iş parçacıklarını asla kısır bırakmamasını garanti eder.
Bu karmaşık iş parçacığı zamanlamasının mimari bir gecikme veya ek yük getirdiğine dair endüstri endişelerini ele alarak, bağımsız testler performans vergisinin olmadığını kanıtladı. Üçüncü taraf donanım sitesi Phoronix tarafından yapılan yakın tarihli derinlemesine bir inceleme, NVIDIA'nın uzamsal çoklu iş parçacığının dikkate değer bir verimlilik artışı sağladığını doğruladı.
Özetle: Vera genel olarak Grace'ten 1,5 kat daha hızlı ve özellikle Python betikleme ve LLVM derleme gibi ajans iş yüklerinde önde gelen x86 rakiplerinden 2 kat daha hızlıdır. NVIDIA'nın özel uzamsal çoklu iş parçacığı bir vergi getirmez; aksine, yoğun yükler altında bile optimum kaynak dengesini korumak için işçi ve G/Ç iş parçacıklarını tahsis eder. Phoronix tarafından yapılan üçüncü taraf bir analiz, bu çoklu iş parçacığının aslında yaklaşık %20'lik bir performans artışı sağladığını doğruladı.
NVIDIA'nın CPU-GPU Oranının Nihayetinde Nerede Bulunabileceğine Dair Görüşü
Soru: Meta'nın Muse ajanını piyasaya sürdüğünde, yapay zeka ortamlarındaki CPU-GPU oranının eninde sonunda 80:1'e ulaşabileceğine dair bazı bilgiler ortaya çıktı. Bu gerçekçi mi ve Vera'nın talebini nasıl etkiliyor?
Yanıt: NVIDIA resmi olarak 80:1 oranını onaylamasa veya öngörmese de, ajan araç çağrılarının endüstri hacmi devasa olup, bazı sanal ortam sağlayıcıları tek bir müşteri için 400.000'e kadar sanal ortam barındırıyor. Potansiyel olarak trilyonlarca çalışan sanal ortamı desteklemek için altyapı oranı aktif olarak CPU'lar yönünde ağır bir şekilde kayıyor ve bu da NVIDIA'nın bağımsız Vera CPU rafları için çaba göstermesini sağlıyor.
NVIDIA Vera'nın Monolitik Çipi
Soru: NVIDIA, Vera için neden rakiplerin kullandığı çip mimarisi yerine monolitik bir çip tercih etti?
Yanıt: Hem sıradan tüketicilere (istemci bilgisayarlar) hem de üst düzey veri merkezlerine hizmet etmek için karmaşık, esnek mimariler tasarlamak zorunda olan eski x86 üreticilerinin aksine, NVIDIA bağımsız CPU alanına tarihsel segmentlerden tamamen arınmış olarak girdi. Bu benzersiz konumlandırma, Vera'yı yalnızca tek bir hedef için tasarlama lüksünü onlara verdi: ultra yüksek performanslı yapay zeka veri merkezi.
Yapay zeka ajanlarının ve veri analitiğinin yoğun bellek alım döngülerini karşılamak için NVIDIA, rakiplerinin çok çip trendini, veri ayrı çiplere veri iletildiğinde ortaya çıkan iç performans "vergisini" tamamen ortadan kaldırmak için tek bir monolitik çip lehine reddetti. Bu monolitik mühendislik, işbirlikçi hesaplama için devasa bir performans avantajı sağlıyor. Vera CPU, eşi görülmemiş 3,4 terabayt/saniye'lik bir bölme bant genişliği elde ederek, tekil işlemci çekirdeklerinin önde gelen x86 çiplerinden 3 kat daha hızlı işbirliği yapmasına ve bağlamsal bilgiyi paylaşmasına olanak tanıyor.
Monolitik yaklaşım, Vera'nın özel performans hedeflerine ulaşmak için matematiksel olarak gerekli olsa da, NVIDIA çip teknolojisi konusunda geleceğe yönelik son derece pragmatik ve tarafsız bir duruş sergiliyor. Şirket, gelecekteki bir pazar fırsatı gerektirirse, katı tasarım felsefeleri yerine mühendislik faydasını seçerek çip tasarımlarına geçiş yapacaktır.
Özetle: NVIDIA, geçmiş segment taleplerinden (veri merkezi ve istemci ihtiyaçlarını dengeleme gibi) arınmış olduğu için, çiplerini yalnızca veri merkezi ve ajans yapay zekası için tasarlama lüksüne sahip. Monolitik bir çip, çekirdeklerin G/Ç sınırlarını geçmeden iletişim kurmasına izin vererek veri hareketini en üst düzeye çıkarır ve önde gelen x86 çiplerinden 3 kat daha yüksek olan 3,4 terabayt/saniye'lik bir bölme bant genişliği sağlar. Yine de NVIDIA, pazar talepleri farklı bir mimariyi gerektirirse gelecekte çip mimarilerine açık kalmaya devam ediyor.