120 milyar parametreli yapay zeka modellerinin, iyi bir performans için genellikle en az 60 GB ile 80 GB arasında VRAM ve sistem belleği gerektirdiği biliniyor. Bu durum, bu tür güçlü yapay zekaları çalıştırmak için yüksek maliyetli donanımlara sahip olmanın kaçınılmaz olduğunu gösteriyor. Ancak, yaratıcılığın sınır tanımadığını gösteren bir örnekte, bir teknoloji meraklısı düşük donanımları ve bir akıllı telefonu bir araya getirerek bu imkansız görünen başarıyı elde etti.
İmkansızı Başardı Ama Hız Beklemeyin!
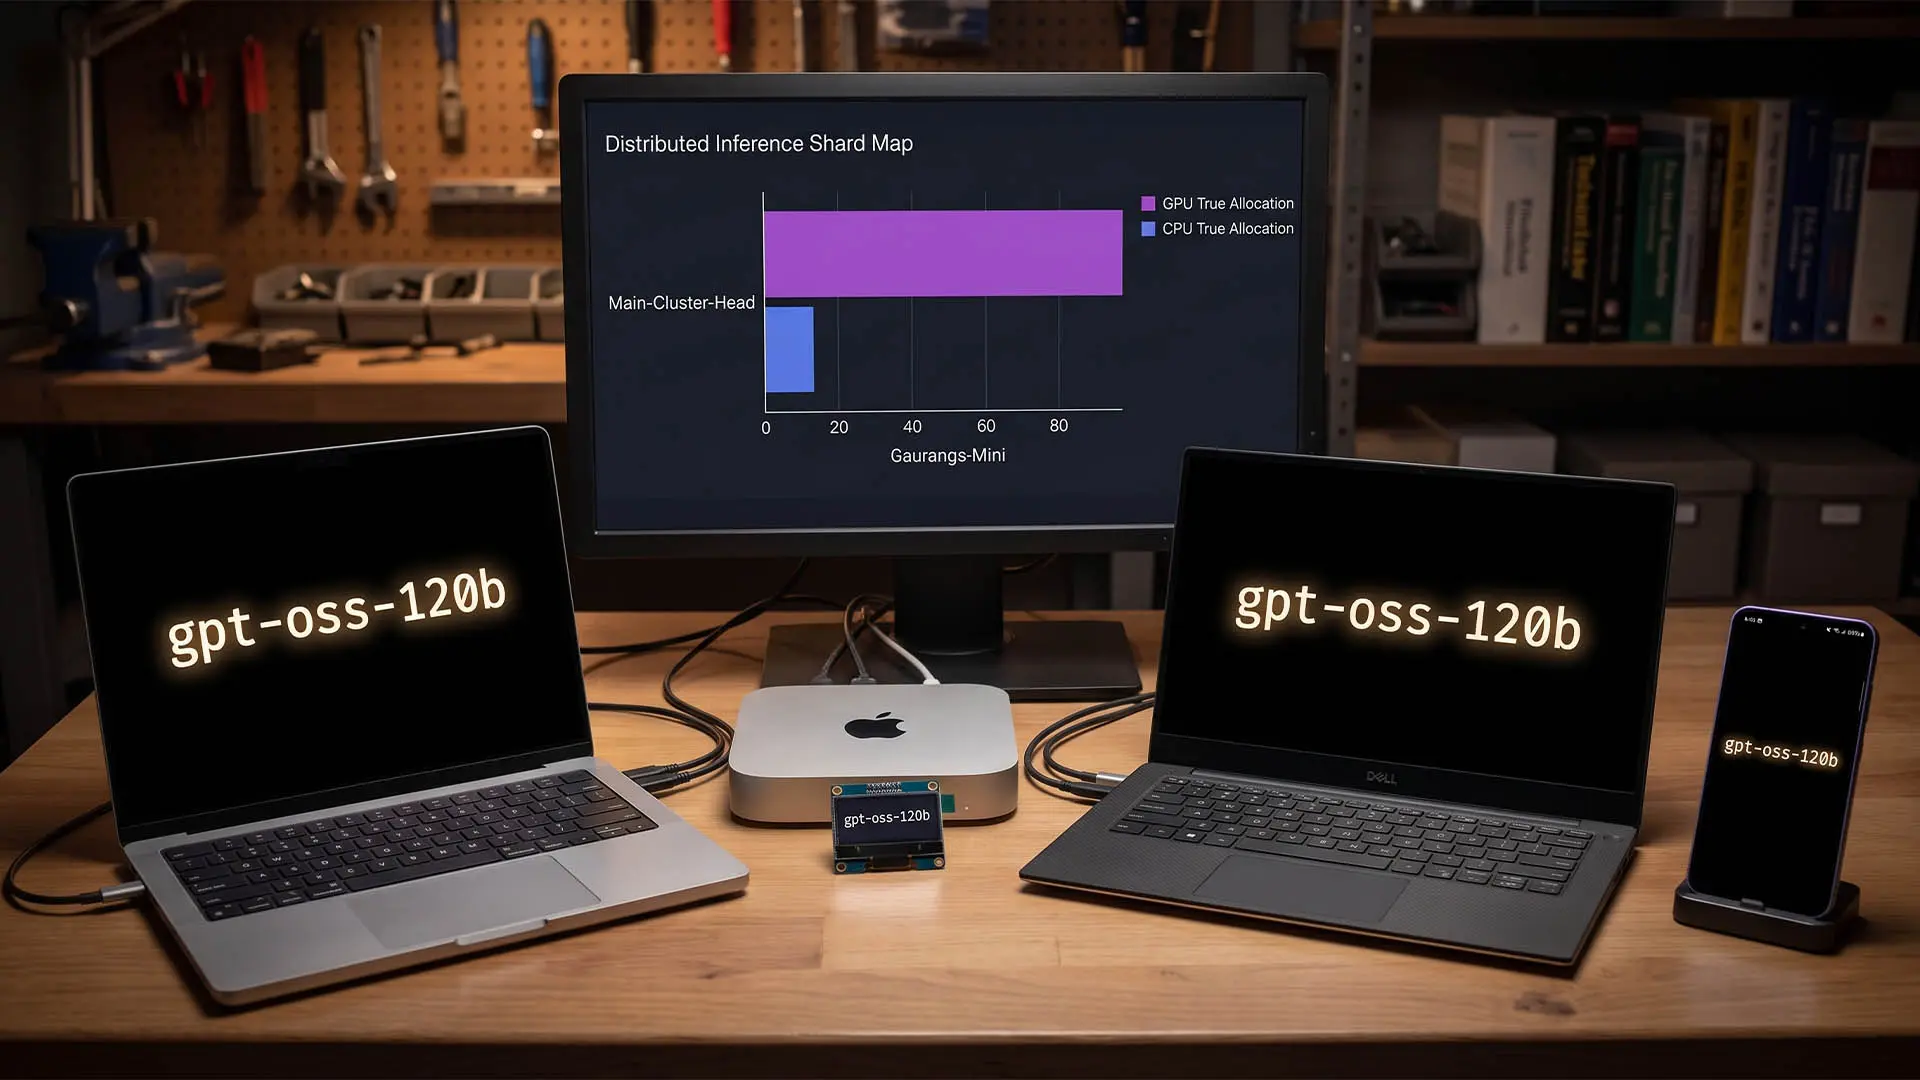
Galaxy S24+, 12 GB VRAM'e sahip bir RTX 3060'lı mini PC, sadece 12 GB belleği olan bir Windows dizüstü bilgisayar ve Intel işlemcili bir MacBook Pro, Mac mini ile M3 MacBook Pro gibi çeşitli cihazları bir araya getiren bir kullanıcı, 4-bit kuantize edilmiş bir yapay zeka modelini başarıyla çalıştırdı. Bu modelin minimumda 60 GB bellek gerektirdiğini belirtmek gerek. Eğer bu modeli ham haliyle çalıştırmayı düşünürseniz, 240 GB RAM'e ihtiyacınız olacağını ve bu durumun çoğu donanım sahibi için pratik olmadığını söyleyebiliriz.
Bu başarıyı sıradan tüketici cihazlarında gerçekleştirmek için iki ana yöntem kullanıldı. Toplam bellek ihtiyacı 47 GB'a düşürüldü ve altı cihazı birleştiren yazılım, "pipeline parallelism" adı verilen bir teknik kullandı. Bu teknikte, yapay zekanın tüm katmanları tek bir bilgisayara yüklenmek yerine, ağdaki her cihaza bölünerek dağıtıldı.
İş yükü buna göre paylaştırıldı. "Tiny" adını verdiği ana bilgisayar, sistem belleğinin yaklaşık 28.7 GB'ını ve RTX 3060'ı kullanarak işin büyük kısmını üstlendi. Günümüzde, gpt-oss-120b gibi yapay zeka modellerini çalıştırmak, genellikle sadece en üst düzey MacBook Pro modelleri veya yeni piyasaya sürülen güçlü dizüstü bilgisayarlar gibi çok pahalı makinelerde bulunan 128 GB birleşik bellek ile mümkün olabiliyor.
Daha düşük belleğe sahip çeşitli makinelerin bu denli yoğun yapay zeka modellerini çalıştırabildiğini görmek, daha fazla kullanıcıya benzer modelleri çalıştırma umudu veriyor. Ancak bu durum, performans açısından önemli bir ödün vermeyi gerektiriyor. Tüm bu cihazlar kümesinde 120 milyar parametreli yapay zeka modellerini saniyede sadece 1.1 token hızında çalıştırmak mümkün olsa da, aktif bir internet bağlantısı olmadan üretkenliği artırmak isteyenler için bu kesinlikle pratik bir yöntem değil.
Eğer bu modeli sabırla çalıştırmaya ve inanılmaz derecede yavaş hızlarda uzun metinler oluşturmayı deneyimlemeye hazırsanız, bu yolu izleyebilirsiniz. Ancak bu cesareti göstermeyenler için daha az yoğun modellere yönelmek en iyi seçenek olacaktır.