2017 yılında tanıtılan Volta mimarisi, yapay zeka (YZ) alanındaki birçok iş yükünde hala iddialı olduğunu kanıtlıyor. Özellikle 32GB HBM2 belleğe ve 900GB/s bant genişliğine sahip Tesla V100, modern çözümlerle rekabet edebilecek güce sahip. Elbette, bu donanımı kurmak ve çalıştırmak için NVLink taşıyıcı kart ve bazı soğutucu modifikasyonları gerekiyordu, ancak bu engeller aşıldığında sonuçlar etkileyici oldu. Dört adet Tesla V100, belirli YZ benchmarklarında güncel çözümlerden %230'a kadar daha iyi performans gösterebiliyor.
Tesla V100, Qwen3.8-Flash-Next Modelinde Güncel Çözümlere Meydan Okuyor
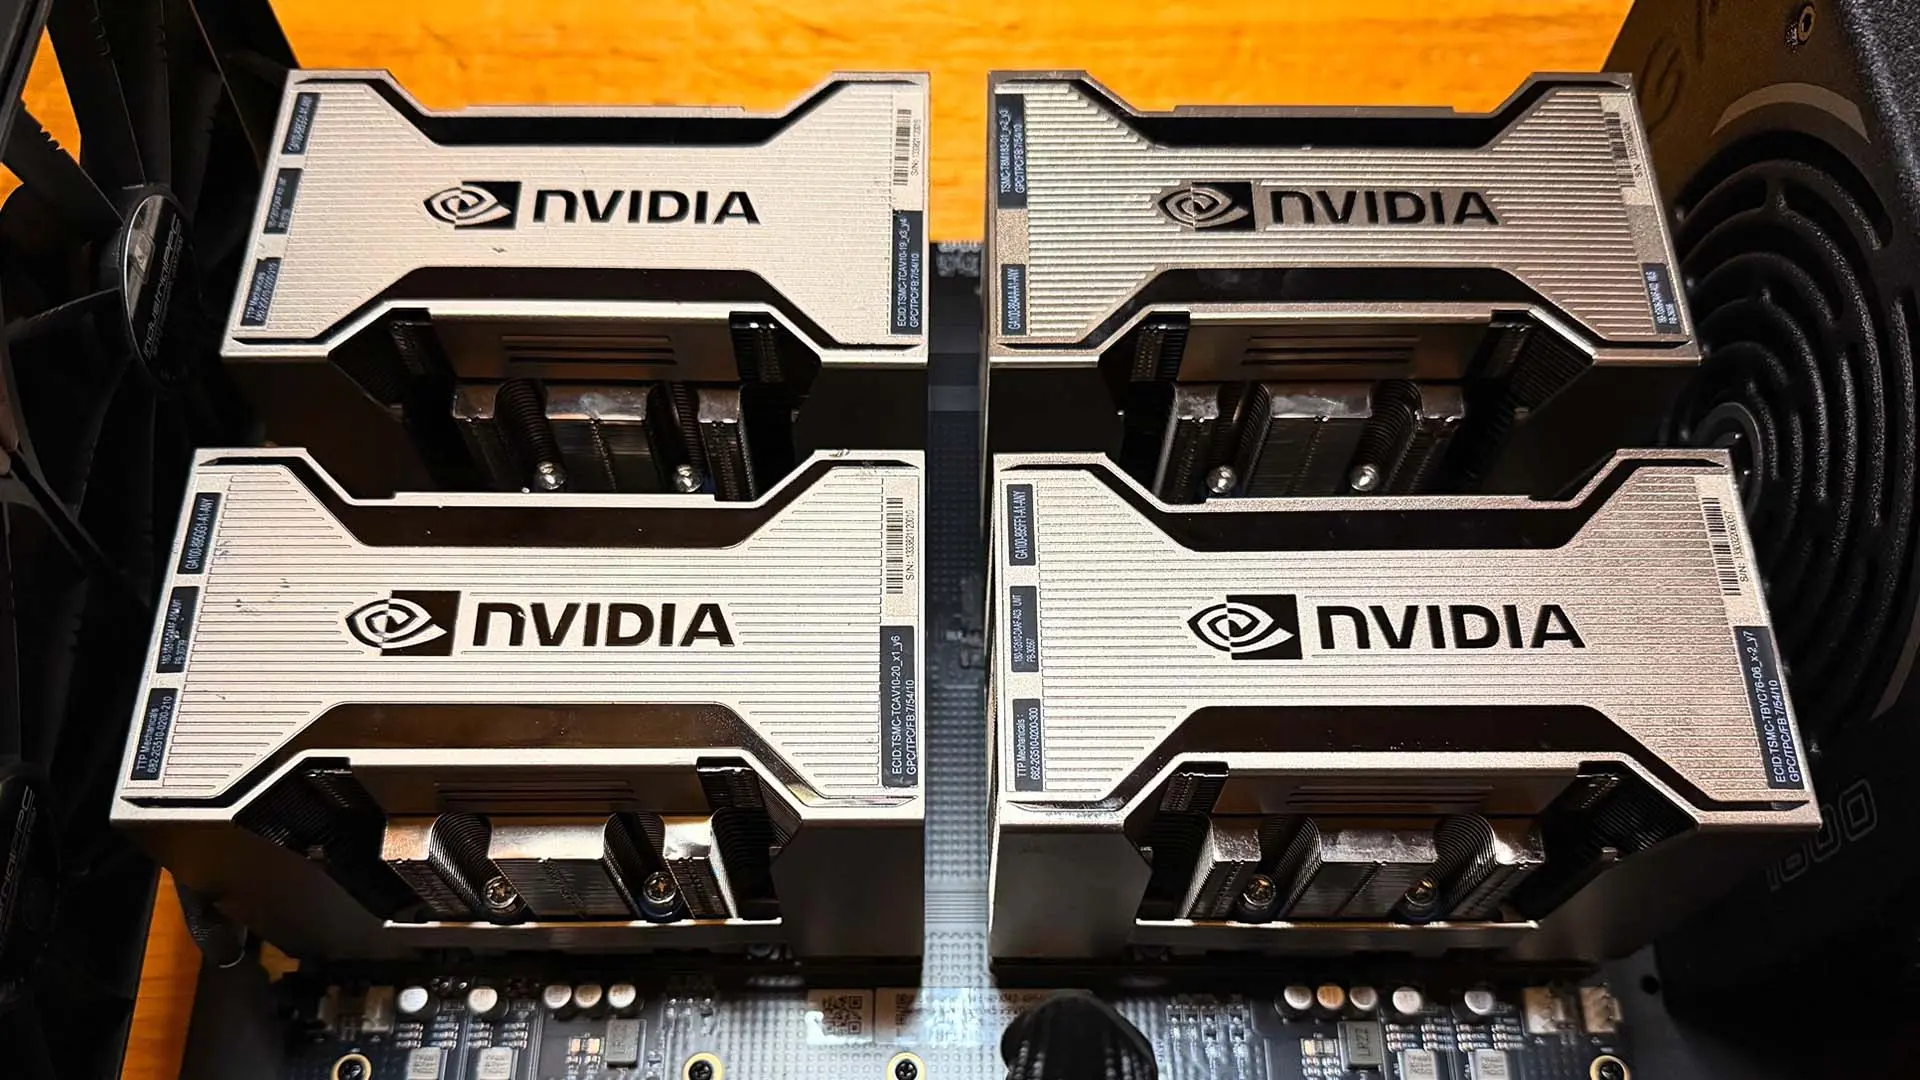
Dört adet Tesla V100'ü bir araya getirmek, NVLink taşıyıcı kart olmadan zor görünse de, YouTuber Jun Yamog ek donanımla bunu başardı. Bu yapılandırma, toplamda altı adet NVLink 2.0 bağlantısı sayesinde 300GB/s bant genişliği ve artırılmış hızlar sağlıyor. Dört Tesla V100 GPU'yu monte etmek kadar, onları etkili bir şekilde soğutmak da önemli bir zorluktu.
Bu sorunu çözmek için Jun, NVIDIA'nın A100 GPU soğutucusunu modifiye ederek V100'e uyacak şekilde ayarladı. İşlem tamamlandığında, bu devasa soğutucu, her bir çipten yayılan 300W gücü rahatlıkla dağıtabildi. Birkaç geçiş adaptörü ile YouTuber, taşıyıcı kartı bir PCIe x8 bağlantısı üzerinden sistemine entegre etti.
Benchmark sonuçlarına gelince, dört adet V100'lük yapılandırma, 128GB LPDDR5X birleşik belleğe sahip iki adet DGX Spark sistemi ve tek bir M5 Ultra ile karşılaştırıldı. 4-bit kuantizasyon ile Qwen3.8-Flash-Next modeli çalıştırıldı. Uzun prompt'lar için prompt işleme görevlerinde, dört adet V100, DGX Spark kümesine göre %40, M5 Ultra'ya göre ise %230 daha hızlıydı. Jun, Apple Silicon ile arasındaki bu büyük performans farkının, muhtemelen yazılım optimizasyonlarının eksikliğinden kaynaklandığını belirtiyor.
Kısa prompt'lar için de benzer bir performans farkı gözlemlendi: Tesla V100 kümesi, DGX Spark ile aynı performansı sergilerken, M5 Ultra'dan %163 daha hızlıydı. Kısa prompt'lar için token üretme hızında ise V100'ler, iki DGX Spark birimine göre %121 daha hızlıydı (100.6 tok/s), M5 Ultra ise 44.5 tok/s hıza ulaştı. Bu sonuçlar, başka bir YouTuber olan Alex Ziskind'in rapor ettiği sonuçlarla da örtüşüyor.
Benchmarklara, Alex'in sekiz adet RTX PRO 6000 GPU'su da dahil edildi. NVIDIA'nın Tesla V100'ünün, büyük dil modellerini (LLM) çalıştırmak için yeniden kullanıldığı tek örnek bu değil. Başka bir kullanıcı da GPU'sunu bir RTX 4080 ile aynı kasada çalışacak şekilde modifiye ederek, ek VRAM ve bant genişliği sayesinde 27 milyar parametreli YZ modellerini iyi performansla çalıştırmayı başardı.
Eğer siz de aylık ücret ödemeden yerel bir YZ sistemi kurma hedefiniz varsa, birkaç adet NVIDIA V100 GPU edinmek harika bir seçenek olabilir. Günümüzde eBay gibi platformlarda, 32GB'lık versiyonunu uygun fiyatlara bulmak mümkün. İki adet edinmek, daha karmaşık YZ modellerini çalıştırma ufkunuzu genişletecektir.