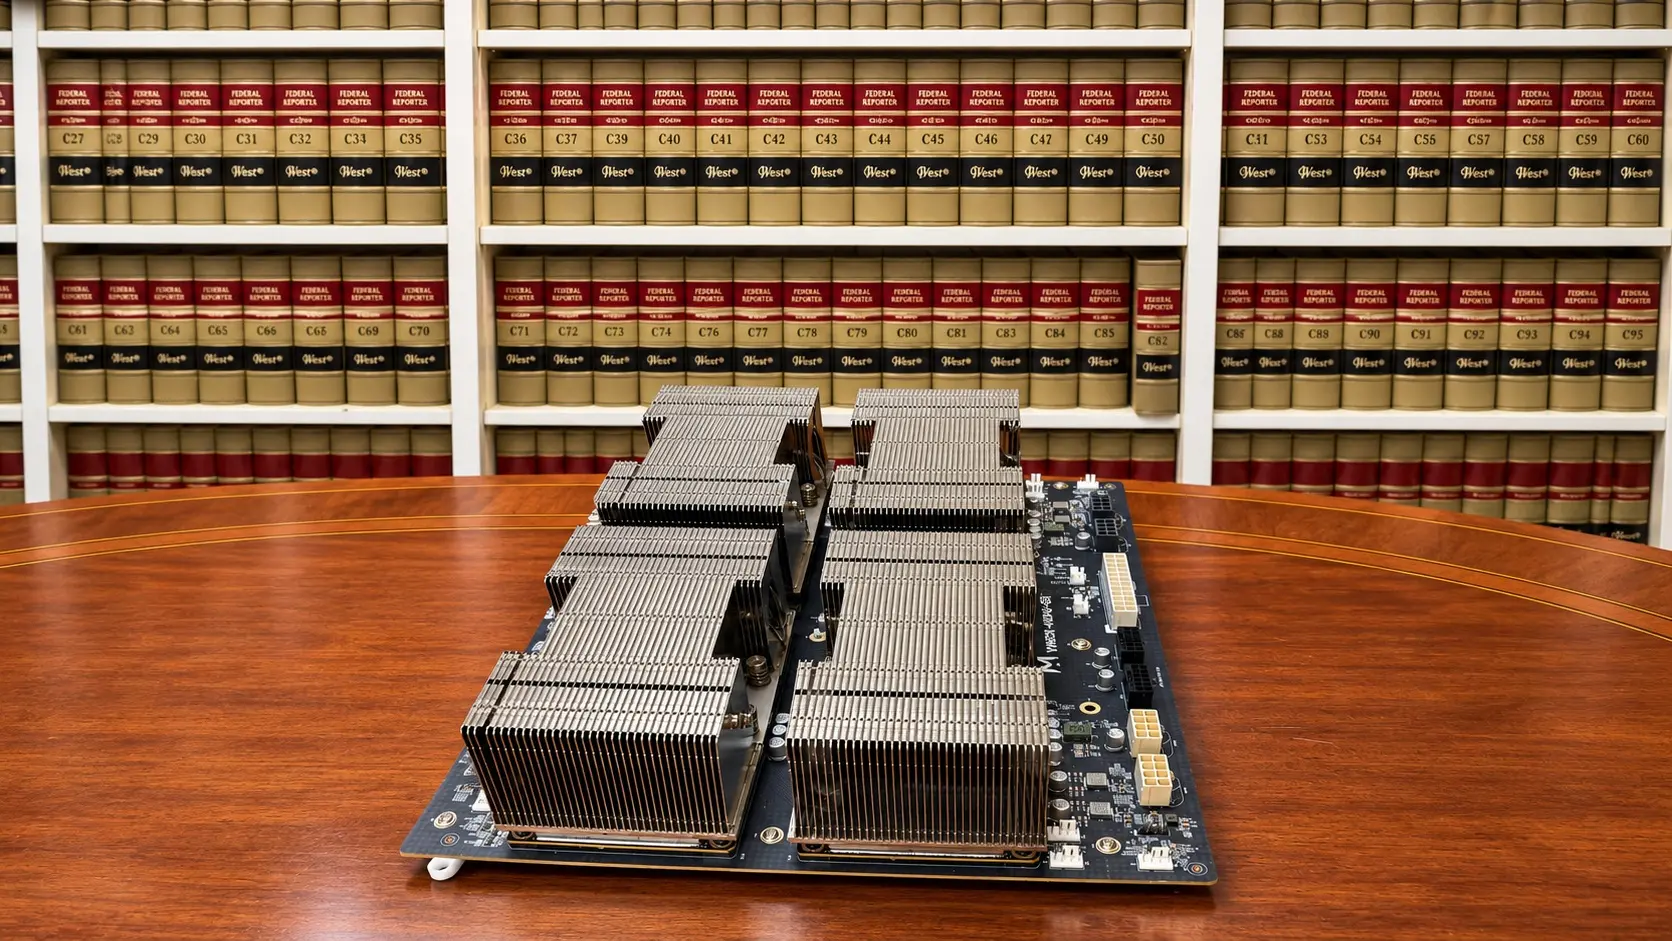
Bir avukat, eskiyen NVIDIA Tesla V100 GPU'larını kullanarak oldukça güçlü bir özel yapay zeka sunucusu kurdu. 2018 model sekiz adet NVIDIA Tesla V100 GPU, toplamda 256 GB HBM2 bellek ile birlikte DeepSeek V4.1-Flash modelini yerel olarak çalıştırmayı başarıyor. İlk testlerde saniyede 215 kod üretim hızı elde eden bu sistem, daha sonra artırılan RAM, geliştirilmiş kuantizasyon ve ek donanımlarla daha da güçlendirildi.
Bu ilginç proje, bir deneme avukatı ve PLI Labs kurucusu olan Nick Mermiges'e ait. Mermiges, özel olarak topladığı bu sistemi öncelikle gizli hukuki belgeleri bulut tabanlı yapay zeka hizmetlerine göndermek yerine kendi donanımında saklamak amacıyla geliştirdiğini belirtti. Sistem, dava dosyalarını işlemek, ilgili bilgileri çıkarmak, belgeleri özetlemek ve taslak metinler oluşturmak gibi görevleri üstleniyor. Ancak her zaman insan kontrolünün zorunlu olduğu vurgulanıyor.
Sekiz Adet NVIDIA V100 GPU ile Yerel Yapay Zeka Çıkarımı İçin 256 GB HBM2 Bellek
Kurulan NVIDIA V100 yapay zeka sunucusu, her biri 32 GB HBM2 belleğe sahip sekiz adet Tesla V100 SXM2 hızlandırıcısını barındırıyor. Bu kartlar, iki adet dörtlü GPU tabanlı karta yerleştirilmiş ve NVLink teknolojisi ile birbirine bağlı. Kartlar arasındaki iletişim ise PCIe 3.0 üzerinden sağlanıyor. Bu bağlantıları dört adet PEX anahtarı ve SlimSAS kabloları yönetiyor.
Her bir V100 GPU, 900 GB/s bellek bant genişliği sunuyor. Ana sistemi AMD Threadripper PRO 3945WX işlemcisi oluşturuyor ve başlangıçta 256 GB DDR4 ECC bellek kullanılmıştı.
Mermiges'in tahminlerine göre, her bir dörtlü GPU grubunun maliyeti yaklaşık 2.400 dolardı ve bu da yalnızca hızlandırıcıların yaklaşık 4.800 dolara mal olduğunu gösteriyor. Bu fiyatlar, ana sistem, güç kaynakları ve diğer bileşenler hariçtir ve geçmişteki alım fiyatlarını yansıtmaktadır.
Özel optimizasyonlar ve iki aşamalı boru hattı paralel düzenlemesi sayesinde, orijinal sistem aşağıdaki sonuçları elde etmeyi başardı:
Çoğunlukla 2-bit kuantizasyon uygulanmış model yaklaşık 248.8 GB yer kaplıyor, ancak her şey GPU belleğine sığmıyor. Uzman modellerin tamamı VRAM'de tutulurken, yaklaşık 110 GB'lık veri sistemi RAM'inde konumlanıyor.
Yeni Yükseltme, Performans Pahasına Yapay Zeka Çıktı Kalitesini Artırıyor
Son olarak Volta Max uPLIft olarak adlandırılan bu güncellemeyle, sık kullanılan uzmanlar NVIDIA'nın NVFP4 hassasiyetine yükseltildi. Kalan uzmanlar ise 2-bit temsilini koruyor. Bu sayede, uzman aktivasyonlarının yaklaşık %80-86'sı artık NVFP4 hassasiyetiyle çalışıyor. Bu durum, NVIDIA'nın referans modeliyle sonraki kelime uyumunu %92.2'den %95.1'e çıkardı. Ancak bu, doğrudan doğruluk ölçümü olmaktan çok, çıktı kalitesindeki bir iyileşmeyi temsil ediyor.
Bu iyileşmenin bir bedeli var: Üretim performansı düştü. Kod üretimi saniyede yaklaşık 150-180 token seviyesine geriledi. Ancak, iki eşzamanlı istekte birleşik verimlilik saniyede 159 token olarak ölçüldü.
Mermiges ayrıca sistem RAM'ini 1 TB'a yükseltti ve taslak oluşturma için bir RTX 3090 ekran kartı ekledi.
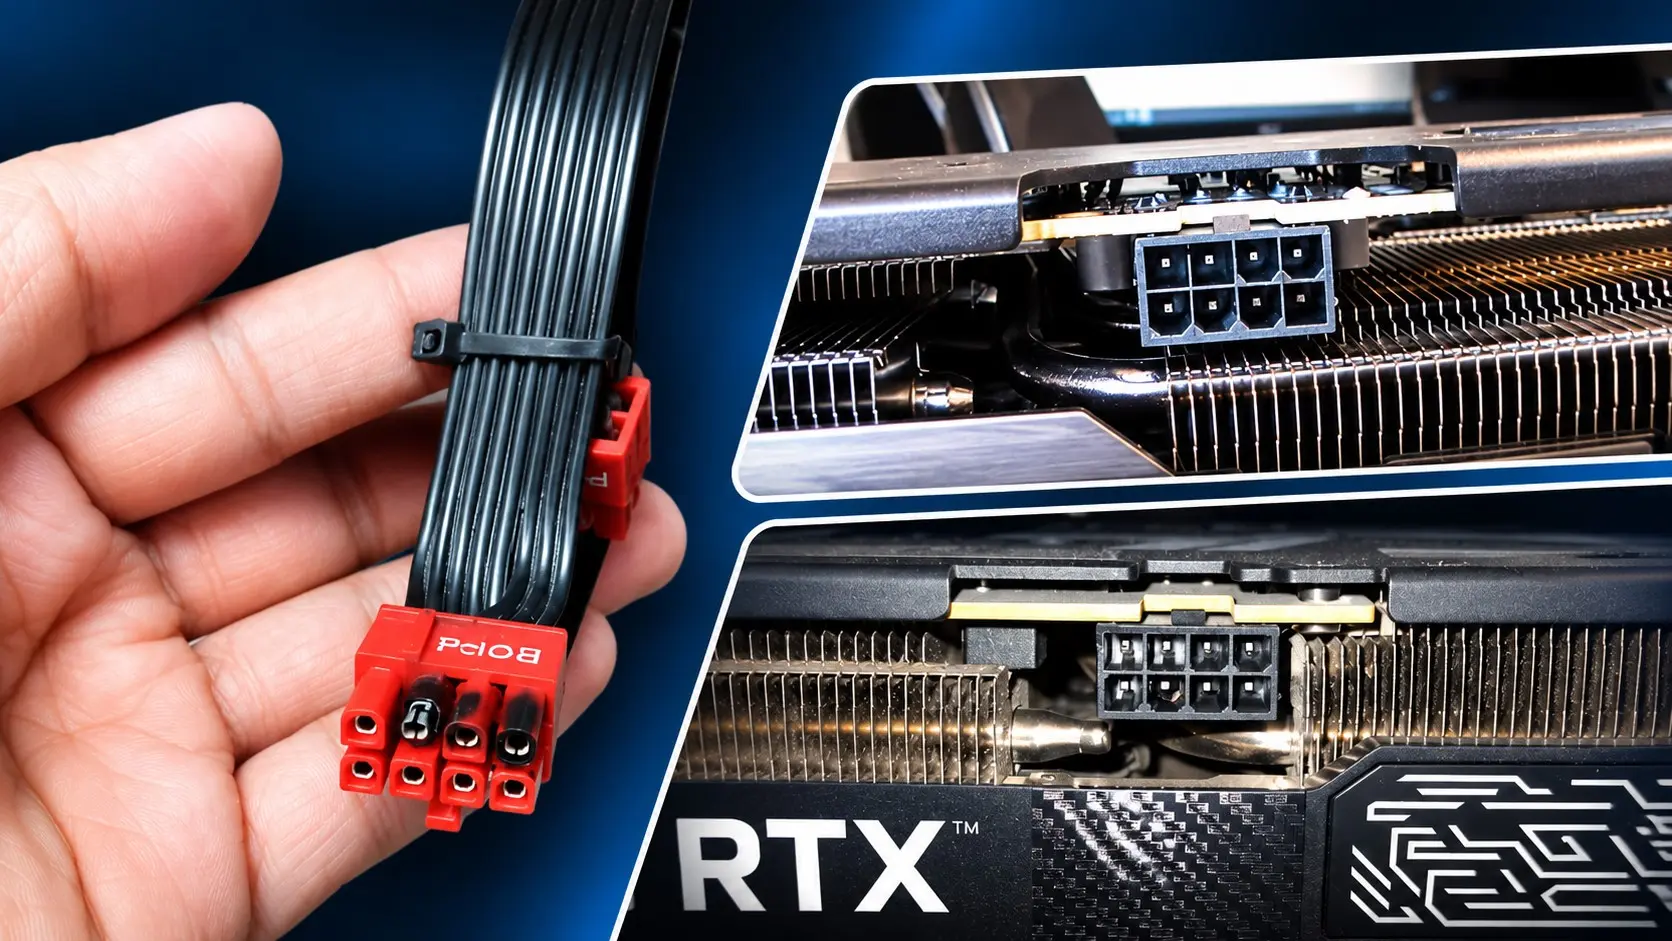
Proje, yanmış bir güç konnektörü, ECC bellek hataları ve güç dağılımındaki sorunlardan kaynaklandığı düşünülen çökmeler gibi çeşitli zorluklarla karşılaştı. Ayrıca, NVIDIA'nın R580 sürücü sürümü, Volta tabanlı kartlar için son desteklenen sürüm olma özelliğini taşıyor.
Buna rağmen Mermiges, özel sisteminin önceki büyük dil modeli iş akışlarının yaklaşık %50-60'ını değiştirebileceğini tahmin ediyor. Bu durum, eski kurumsal düzeydeki GPU'ların, kapsamlı yazılım optimizasyonlarıyla birleştiğinde zorlu yapay zeka uygulamaları için ne kadar kullanışlı kalabileceğini gösteriyor.
Kaynakça: wccftech.com